Eski Belgeler Yapay Zekâyla Nasıl Okunur?
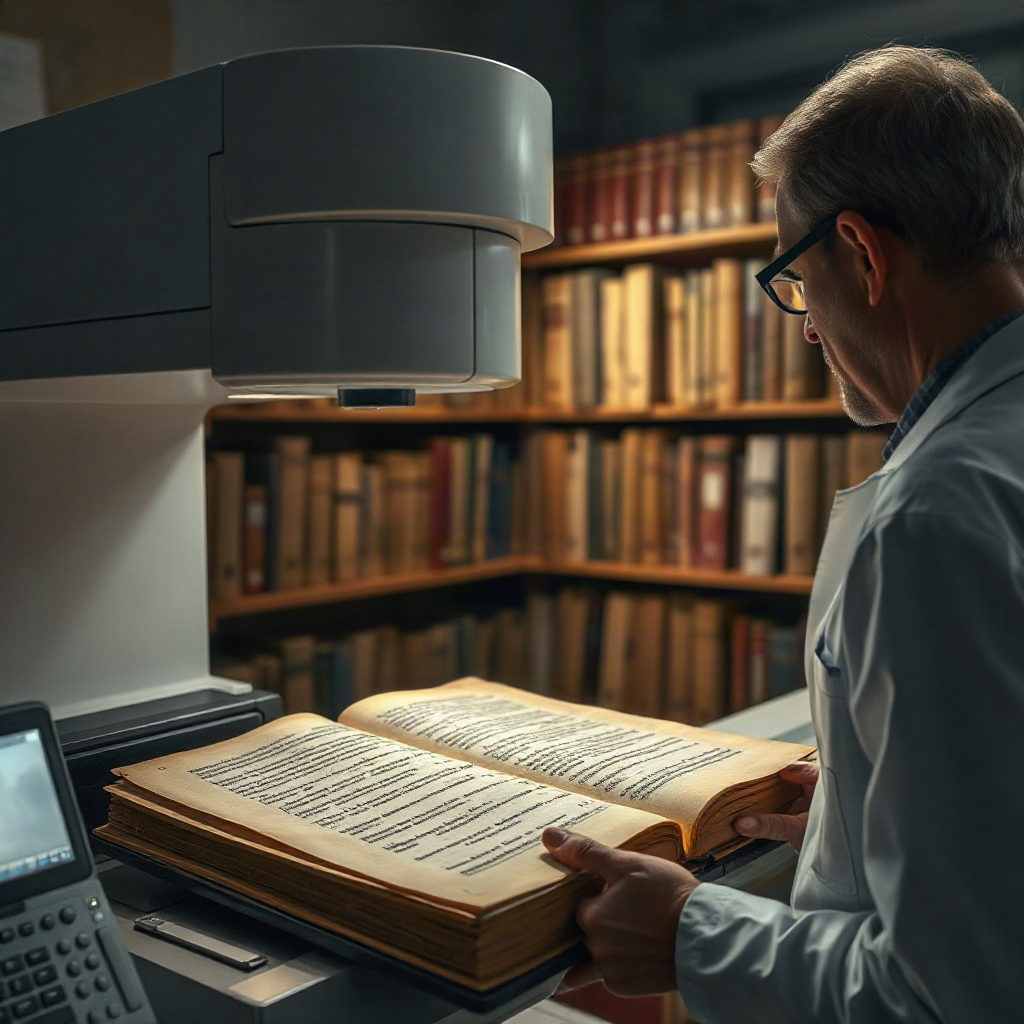
Eski belgelerin okunması, tarih araştırmacıları ve arkeologlar için hayati bir görevdir. Ancak, bu belgelerin çoğu zaman bozulmuş, el yazısıyla karışık veya kalın kurşunla yazılmış olmasına rağmen, günümüz teknolojisi sayesinde artık dijital ortamda okunabilir hale getirilebilir. Yapay zeka, bu süreci hızlandırarak, tarih öncesi metinleri, antik alfabeleri ve tahribata uğramış el yazmalarını yeniden canlandırma yeteneğine sahiptir.
Zamanla, kağıt ve mürekkep üzerindeki izler yavaş yavaş kaybolur, bu da geleneksel okuma yöntemlerini zorlaştırır. Farklı dillerdeki eski el yazmalarının tespit edilmesi, çevirisi ve yorumlanması, uzmanlık gerektiren bir alandır. Ancak, yapay zeka destekli görüntü işleme ve dil işleme teknikleri, bu belgelerin okunabilirliğini artırarak, tarihçiler için yeni bir pencere açar.
Bu yazıda, eski belgelerin yapay zeka ile nasıl okunabileceğini, teknolojinin tarihsel sürece nasıl katkıda bulunduğunu ve gelecekte bu alanda neler beklenebileceğini ele alacağız. Ayrıca, bu teknolojinin pratik uygulamaları, gerçek hayat örnekleri ve sık yapılan hatalar hakkında bilgi sunacağız.
Temel Kavramlar ve Tanımlar
Eski belgeler ile ilgili ilk adım, “döküman tanıma” ve “metin tanıma” kavramlarını kavramaktır. Döküman tanıma, bir görüntüdeki metin bölümlerini tespit etmek ve bu bölümlerin konumlarını belirlemek için kullanılan tekniklerdir. Metin tanıma (OCR), ise tespit edilen metin bölümlerini dijital yazıya dönüştürmek için kullanılır.
Yapay zeka destekli OCR sistemleri, geleneksel OCR’dan farklı olarak derin öğrenme modelleri kullanır. Bu modeller, farklı yazı tiplerini, el yazılarını ve bozulmuş karakterleri tanımada çok daha başarılıdır. Örneğin, bir antik Mısır hiyeroglif belgesinde, her bir hiyeroglifin görsel özellikleri derin sinir ağları tarafından öğrenilir ve doğru karakterle eşleştirilir.
Bir diğer önemli kavram ise “dil modellemesi”dir. Dil modelleri, elde edilen metinlerin dilbilgisel bütünlüğünü kontrol eder ve hatalı çevirileri düzeltir. Bu sayede, tarihsel metinlerdeki dilsel karmaşıklıklar, yapay zeka sayesinde daha anlaşılır bir şekilde sunulabilir.
Eski Belgelerin Dijitalleştirilmesi Süreci
Dijitalleştirme süreci, öncelikle belgeyi yüksek çözünürlükte taramakla başlar. Bu adımda, dokümanın bütünlüğü korunmalı ve mümkün olan en fazla detay yakalanmalıdır. Tarama sonrası, görüntü kalitesi artırmak için kontrast, parlaklık ve renk düzeltmeleri yapılır.
İkinci aşama, görüntü işleme teknikleri ile metin alanlarını ayırmaktır. Özellikle el yazıları için, görüntü üzerinde kenar tespiti ve segmentasyon algoritmaları uygulanır. Bu sayede, metin blokları ve satırlar net bir biçimde tanımlanır.
Son adımda, derin öğrenme tabanlı OCR modelleri uygulanır. Model, eğitilmiş ağırlıkları sayesinde karakterleri tanır ve metni dijital formata çevirir. Bu süreç, hatalı karakterleri düzeltmek için dil modeliyle entegre edilir, böylece metin bütünlüğü sağlanır.
Yapay Zeka ile Tarihi Dil Çözümleme
Eski belgelerde kullanılan diller, modern dillerden çok farklı yapıya sahip olabilir. Bu yüzden yapay zeka, dil çözümleme aşamasında kritik bir rol oynar. Öncelikle, dilin karakter seti ve gramer kuralları modelin eğitilmesinde kullanılır. Öğrenme sürecinde, model benzer dil örnekleriyle beslenir ve dilin yapısal özelliklerini öğrenir.
Daha sonra, model elde edilen metni analiz eder. Örneğin, antik Yunanca bir metinde, dil modeli cümle yapılarını, zamir kullanımını ve dilbilgisel bağlamı değerlendirir. Böylece, çeviri hataları minimize edilir ve metnin orijinal anlamı korunur.
Bu süreç, özellikle çok dilli metinlerde büyük avantaj sağlar. Örneğin, Orta Çağ Avrupa’sındaki belgelerde Latin, Fransızca ve Almanca karışık olarak kullanılabilir. Yapay zeka, bu dillerin hepsini aynı anda tanıyıp çevirebilir, böylece araştırmacıların çalışma süresi büyük ölçüde azalır.
Gerçek Hayat Örnekleri Başarılı Uygulamalar
Birçok müze ve arkeolojik site, yapay zeka destekli OCR sistemlerini kullanarak eski belgeleri yeniden canlandırmıştır. Örneğin, Mısır’daki bir tapınağın üzerindeki hiyeroglifler, derin öğrenme modelleriyle milyonlarca karakterin hızlı bir şekilde tanımlanmasını sağladı. Bu sayede, tapınağın tarihçesi hakkında yeni bilgiler ortaya çıktı.
İngiltere’de, Orta Çağ’dan kalma bir manastır metni, yapay zeka ile tarandı ve orijinal metin dijitalleştirildi. Bu metin, araştırmacılar için erişilebilir hale getirildi ve yeni bir tarihsel analiz yapılmasına olanak sağladı.
Bir diğer örnek, Mesoamerika’da bulunan çamur tabletlerin yapay zeka ile okunmasıdır. Bu tabletlerdeki aztek yazıları, derin öğrenme modelleri sayesinde çözülerek, eski Aztek kültürü hakkında önemli ipuçları elde edildi.
Sık Yapılan Hatalar ve Dikkat Edilmesi Gerekenler
Eski belgelerin yapay zeka ile okunmasında en yaygın hata, yetersiz veri setiyle eğitilen modellerin kullanılmasıdır. Modelin, belgelerde kullanılan yazı tipleri ve dillerle ilgili yeterli örnekle beslenmemesi, yüksek hata oranlarına yol açar.
Bir diğer hata, görüntü kalitesinin düşük olmasıdır. Özellikle eski belgelerde, mürekkep solmuş veya kağıt yıpranmış olabilir. Bu durumda, görüntü işleme adımlarında kontrast ve parlaklık ayarları yapılmadan OCR uygulanması, yanlış karakter tanımına neden olur.
Son olarak, dil modeli entegrasyonunun eksik yapılması, anlam bozukluklarına yol açar. Model, dilin dilbilgisel kurallarını bilmediği takdirde, çeviri sonuçları tutarsız ve yanlış olabilir. Bu yüzden, dil modeliyle birlikte çalışmak kritik öneme sahiptir.
Uzman Önerileri ve İpuçları
– Veri Toplama: Modeli eğitmeden önce, mümkün olduğunca çok farklı belge örneği toplayın.
– Görüntü Kalitesi: Tarama sırasında yüksek çözünürlük kullanın ve gerekirse kontrastı artırın.
– Model Seçimi: Derin öğrenme tabanlı OCR modellerini tercih edin; klasik OCR sistemleri eski belgelerde yetersiz kalır.
– Dil Modeli Entegrasyonu: Dil modeli, metin düzeltme ve bağlam analizi için zorunlu olmalıdır.
– Hata Kontrolü: Çıkan sonuçları uzmanlarla birlikte gözden geçirin; otomatik sistemler her zaman doğru değildir.
– Sürekli Güncelleme: Modeli yeni belgelerle yeniden eğitin; dil ve yazı tipleri zamanla değişebilir.
– İşbirliği: Arkeologlar, dilbilimciler ve bilgisayar bilimcileri arasında işbirliği kurun.
– Erişilebilirlik: Dijitalleştirilen metinleri açık erişimli veri tabanlarında paylaşın.
– Etik Kurallar: Özel veya hassas belgeler için etik kurallara uyun; izin alınmadan paylaşım yapmayın.
– İç Link: [link]
Sıkça Sorulan Sorular
1. Eski belgelerin okunmasında yapay zeka ne kadar doğru sonuç verir?
Yapay zeka, özellikle derin öğrenme tabanlı OCR modelleriyle yüksek doğruluk sağlar. Ancak, belge kalitesi ve model eğitimi gibi faktörler doğruluk oranını etkiler. Ortalama olarak %90-95 doğruluk elde edilir, ancak kritik belgelerde insan denetimi önerilir.
2. Yapay zeka ile elde edilen dijital metinler telif hakkı kapsamında mıdır?
Çoğu eski belge telif hakkı dışındadır; ancak bazı modern belgeler veya özel koleksiyonlar telif hakkına sahip olabilir. Dijitalleştirilen metinleri paylaşmadan önce ilgili kurumlarla iletişime geçmek önemlidir.
Sonuç
Yapay zeka, eski belgelerin okunmasında devrim yaratmıştır. Görüntü işleme, derin öğrenme ve dil modellerinin birleşimiyle, tarih öncesi metinler artık dijital ortama aktarılabilir ve geniş kitlelere sunulabilir. Bu teknoloji, araştırmacıların zamanını kısaltırken, tarihsel verilerin daha doğru yorumlanmasını sağlar. Gelecekte, yapay zeka destekli sistemlerin daha da gelişmesiyle, eski belgelerle ilgili keşifler hızla artacaktır.